AI 模型怎样变小,又可能丢掉什么?
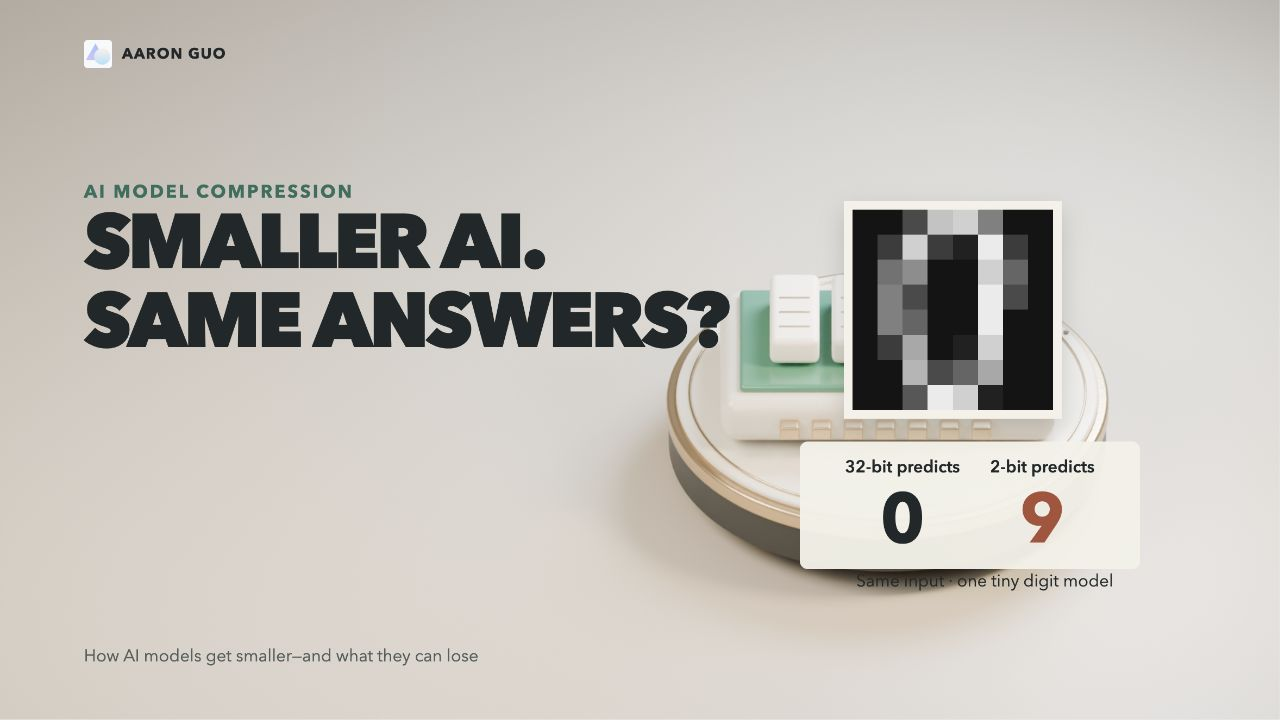
一个识别手写数字的小模型,从 2,616 字节缩到了 416 字节。在同样的 540 张测试图片上,答对数量从 522 降到 520。
再压到 256 字节,答对数量降到了 390。一张原本识别为 0 的图片,现在被判断成了 9。
这是我们用一个已训练的小分类器和简单量化方法做的教学实验。它把取舍摆了出来:保存的模型可以小很多,同时保留大部分表现;但精度变得过于粗糙时,更多答案会发生变化。怎么选,要看你的任务需要什么答案。
How AI Models Get Smaller—and What They Can Lose
用更少的数值表示原来的信息
想象量一块搁板:83.7 厘米,取整记成 84 厘米,可能仍足够用来决定摆放位置。如果只保留到十厘米,83.7 就成了 80。要把它装进两面墙之间,这个误差可能就不能接受了。
模型里有许多叫作权重的数值。量化用更少的比特保存其中一些数值,再通过缩放系数,把保存的编码对应回近似值。4 比特能表示 16 种编码,8 比特能表示 256 种。Hugging Face 的概念说明介绍了这些方式及其取舍。
变化发生在数值表示上,输入图片可以完全不变。某个权重的变化会不会改变最终答案,取决于模型、方法和输入。
同样的 540 张图片,四个保存版本
我们使用 scikit-learn 的手写数字数据集,训练了一个小分类器。测试图片保持不变,再用四种权重精度保存同一个模型。
| 权重精度 | 保存文件大小 | 540 张图片中答对数量 |
|---|---|---|
| 32 比特基准 | 2,616 字节 | 522 |
| 8 比特 | 736 字节 | 522 |
| 4 比特 | 416 字节 | 520 |
| 2 比特 | 256 字节 | 390 |
4 比特版本的保存文件约小了 6.3 倍,答对数量少了两张。8 比特版本答对数量相同;但仅凭总数相等,不能断言每张图片的预测都完全相同。
这些文件还包含文件头、偏置,以及量化版本需要的缩放系数。因此,完整的 4 比特文件并不是 32 比特文件大小的严格八分之一。
这个结果不能证明“4 比特总是安全”或“2 比特一定不行”。它只来自一个小分类器、一次固定的数据划分和一种简单方法。现代量化方法与语言模型的表现可能不同。
文件大小不能代替等待时间
实验中,我们把每个版本解包、还原成浮点数,再运行相同的计算。这里测量的是保存文件大小和预测结果,没有测运行内存或速度。
真实的低精度运行需要相应的软件和硬件支持。下载更小确实有用,但不能据此知道你的电脑完成任务要等多久。存储、运行内存、答案质量和等待时间,需要分别测量。
用自己的任务来选择
替换模型之前,收集一小组你真正关心的任务。放进几个简单例子、几个容易出错的例子,以及答错后会影响决定的情况。先写清楚什么结果算可接受。
把相同输入交给不同版本,查看发生变化的答案,并在自己的机器上记录完成任务的实际时间。有条件时,再记录存储和内存占用。小模型可能是很好的取舍,但某个关键任务失败,也可能比漂亮的平均值更重要。
这次实验值得记住的是两个具体结果:416 字节、答对 520 张;对照版本为 2,616 字节、答对 522 张。文件确实变小了,答案差异也确实存在。选择能够满足要求的最小版本,而判断依据应该来自你真正要它完成的工作。