Sonnet 5.5:effort 不是越高越好
Sonnet 5.5 的发布说明里藏着一个值得注意的细节:在一项代码评测中,把 effort 调到 Max,得分反而低于 Xhigh。
Anthropic 在 9 月 28 日的发布说明中解释了原因。FrontierCode 判断的是代码改动能不能不经人工修改就合并。超出任务范围的改动,即使质量不错,也会扣分。Max 下,Sonnet 更常调用一个会分给多个子代理的代码审查技能。Cognition 检查的两个案例中,额外审查带来了超时或超出范围的修改。这是厂商对特定评测现象的说明,不能据此说 Max 普遍更差。官方发布说明,脚注 2
真正值得带回工作里的,是一个判断:AI 交回的结果不满意时,“让它再多想一会儿”只是一个选项。有时候,少的那条指令是做到哪里可以结束。
按钮修好了,补丁却多出一个决定
看一个虚构的结账页面。按钮上的英文写成了 Pay securly,任务是改成 Pay securely,保持付款行为,其他设置不动。
为了说明这个问题,我们为本文做了两份补丁,并在本地运行检查。两份都是人为构造的示例,没有交给 Sonnet 生成。它们展示的是如何判断任务完成,不是 effort 设置的对比实验。
补丁 A 只修正按钮文字。补丁 B 修正了同一个错字,还顺手把页面背景改成紫色,把收据语气设置改得更亲切。紫色可能更好看,收据也可能值得改,但这些都需要另一个决定。
功能检查对两份补丁都放行:按钮文字正确,点击一次仍然只调用一次 48 美元的付款请求。任务检查只对 A 放行,因为 B 同时改了设置文件。原来那个有错字的版本,则没通过文字检查。
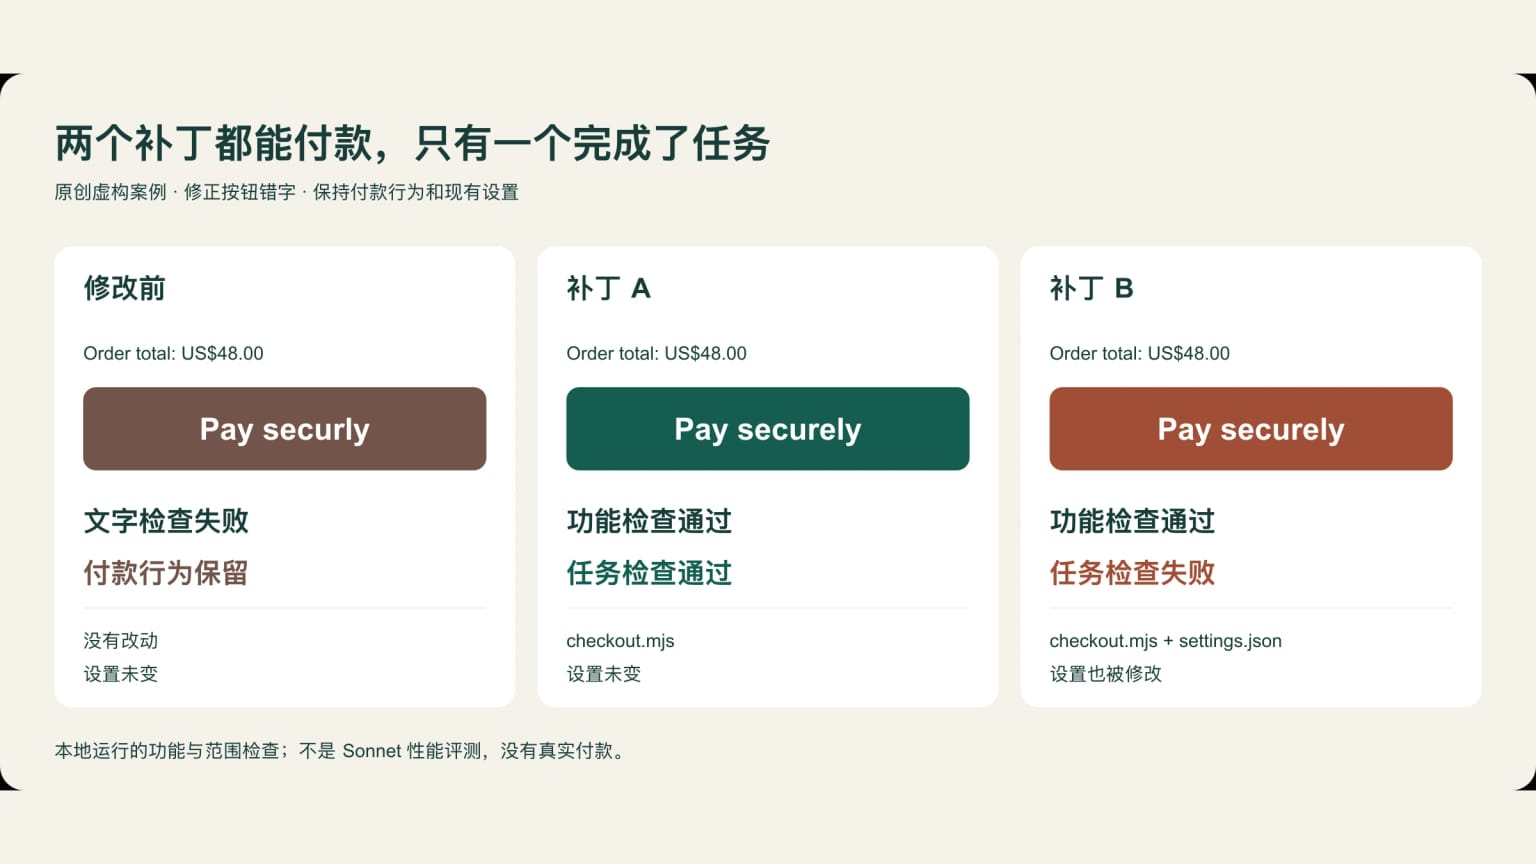
原创虚构案例,10 月 5 日在本地运行。没有模型对比,也没有真实付款。示例代码、完成条件和运行结果保留在制作源文件中。
这里不需要把 B 定性成坏代码。问题在于,现在得有人决定,新设置是否应该跟着这次修复一起上线。本来可以结束的小任务,多了一轮审阅。
如果完成报告只列成功项,这件事很容易被掩盖:修好了文字,保留了功能,还改善了页面。看一下改动文件列表,就会发现另一层意思:它要求负责人接受没有提出过的工作。
多一次审查,也可能多出一批工作
代码审查当然可能发现真正的缺陷。它也可能提出一些可选改进:变量名更清楚、排版更好、附近代码顺便整理一下。单独看,每条建议都可能合理。
范围扩大的时刻,是“可以考虑”悄悄变成了“已经实施”。结果仍然能通过原来的功能检查,但整个补丁变得更难直接接受。再跑一次同样的功能检查,找不出这个区别,因为它已经通过了。
Sonnet 的脚注让这个机制值得认真看一眼。更多 effort 给了模型继续调查和审查的空间,但哪些发现必须立刻落实,仍然需要单独定义。审查可以交回建议,不必自动扩大修改范围。
原创示意图。把可选改进保留为建议,等它们明确属于这次任务后再实施。
对这个按钮案例,一条够用的指令并不长:
把按钮文字从“Pay securly”改成“Pay securely”。保持金额、币种和点击行为,现有设置不动。检查文字和付款行为,再核对改动,交回补丁。无关建议单独列出来。
这比笼统地要求“做得彻底一些”更容易执行:要交付什么、哪些东西不能变、什么证据说明完成,都写清楚了。
先看失败在哪,再调 effort
如果 AI 没有偏离任务,却得出了错误答案,多一些推理可能有帮助。复杂的依赖、几种竞争的解释、不熟悉的算法,都可能值得继续调查。重点是下一次尝试有没有解决那个不确定的问题。
如果答案已经正确,补丁却带着无关修改,先补清楚边界。多想一会儿,并不能替负责人决定那些改动是否属于这次交付。把必要修复和可选建议分开,再用原来的要求核对改动。
如果任务已经说清楚,相关检查也做了,仍然解决不了,就重新看模型、工具和上下文。重复提高设置,未必比补上缺失的文件或一份正确的行为示例更有用。
这几类失败需要不同的处理。全部归因于“想得不够”,就把 effort 当成了一个能替我们决定所有事情的旋钮。
调查任务,需要留出发现范围的空间
这个错字案例故意选得很简单。“查清结账为什么偶尔失败”是另一种工作。问题可能出在付款处理、重试逻辑,也可能是配置。死守一个文件的限制,反而可能挡住调查。
这种任务可以允许广泛调查,同时说清楚怎么从调查进入修改:先复现,解释原因,指出必要改动,遇到影响较大的范围扩展时明确提出。让高 effort 去解决值得深入的问题,也给它与问题相配的完成条件。
即使是小小的错字任务,也有例外。如果修复必须带着一个依赖修改才能生效,AI 应该把原因说明白。停止规则要拦住随手扩张,也要让真正必要的发现能到达负责人。
选 effort 的时候,也把终点选好
Sonnet 5.5 的发布,让 effort 更值得关注。它的脚注也提醒我们:得分对应的是一个有验收标准的任务。更多动作有没有用,要看它是否把结果推向那个标准。
日常修复,可以把完成状态写得很具体:要求的修改有效,需要保留的行为没变,实际改动属于约定的工作。调查任务,则要把还有哪些疑问、允许怎样扩展说清楚。
下次 AI 交回一份看起来很厉害、却仍然不能直接合并的补丁,先看它为什么不能接受,再要求更强的一轮尝试。可能需要更多推理,可能缺上下文;也可能它已经会解决问题,只缺一句更清楚的“到这里就可以停了”。