OpenAI 把我的 $200 套餐砍了一半,我算了算自己的 AI 账单
9 月 29 日,我收到 OpenAI 关于 Pro 200 套餐的邮件。从 10 月 30 日起,这个套餐在 Codex 和 ChatGPT Work 里包含的用量,从 Plus 的 20 倍降到 10 倍;聊天里的 GPT-6 Pro 消息从每周 200 条降到 100 条。价格不变。老用户在 10 月 29 日前保留原额度,并一次性获得 62,500 点使用额度,价值 2,500 美元,年底到期。同一封邮件还宣布了 Pro 500:每月 500 美元,Plus 的 25 倍,也是唯一带 Ultrafast 的档位。
让我一直在想的不是“砍了一半”,而是计量单位。前一晚,负责 Codex 的 Tibo 写道,新套餐“折算下来,是旧 Pro $200 一半的 API 美元”。这句话说清楚了订阅现在是什么:一笔以 API 美元计价的预付预算。既然如此,就该像工程师读云账单那样读它:按标价给自己的工作量算账,找出占比最大的那一项,再把工作交给能用更少钱做好的模型。
所以我拿自己的日志算了一遍。结果有两处出乎我意料:哪个套餐给我更多,以及钱到底花在了哪里。
批量折扣没了
“20 倍”一直是个奇怪的单位,它是一个谁也看不见的 Plus 额度的倍数。但把几个档位排在一起,变化就很清楚:
| 套餐 | 价格 | 用量(Plus 的倍数) | 每 1 倍的价格 |
|---|---|---|---|
| Plus | $20 | 1× | $20 |
| Pro 100 | $100 | 5× | $20 |
| Pro 200(10 月 29 日前) | $200 | 20× | $10 |
| Pro 200(10 月 30 日起) | $200 | 10× | $20 |
| Pro 500 | $500 | 25× | $20 |
旧的 Pro 200 是唯一一个“买得越多、单价越低”的档位。10 月 30 日以后,每一档都是每 1 倍 20 美元。Pro 500 的单价并不更便宜,它卖的是更高的上限和速度。这个形状你在任何云厂商那里都见过:统一费率,性能另外加价。
OpenAI 的说法是,现在每一美元能买到更多。Tibo 说公司不想为了让订阅显得慷慨而抬高 API 标价,宁可直接给模型降价。它也确实降了:GPT-6 Sol 和 Luna 降价 50%,DevDay 发布的 GPT-6.1 Sol 标价是每百万 token 输入 2 美元、输出 10 美元,是 GPT-6 Astra 的五分之一。额度按美元算少了一半,但有些美元更经花了。
社区听到了什么
大多数人听到的是一次换了说法的涨价,而发布方式让情况更糟。砍额度的消息在 DevDay 主题演讲前大约十小时发出。Gabriel Horwitz 把它列为这次发布最该避免的错误之首:“别在自己的大日子前一晚砍用户的套餐。”我在 Hacker News 上反复看到的回复,针对的是措辞而不是数字:“直接说‘我们把额度砍半’。就五个词。”好几位评论者说,自己已经把写代码的主力换成了 Claude Opus 5.5。也有人把整件事看成一次升级销售:把 Pro 200 砍到不够用,再卖 Pro 500。
我看到互动最多的一条帖子,观点正好相反。@miu21590 估算旧 Pro 每月大约相当于 14,000 美元的 API 用量,新版约 7,000 美元,Claude Max 约 8,000 美元,“同样 200 美元,差别不大”。我没法核实这个估算,我自己的日志也远远达不到这个数,虽然日志看不到计量器统计的全部内容。但注意这场争论用的是什么单位:双方都已经在用 API 美元比较订阅了。变化就在这里。
按标价算,我的账单
我每月付 200 美元订 ChatGPT Pro,200 美元订 Claude Max 20x。我每天都用 Codex 和 Claude Code,经常同时跑好几个 agent。这两个工具都会在本地留下会话日志,记录每一轮的 token 数;Codex 的日志还记录了每周用量计量器的读数。我取了主力电脑上最近 30 天(8 月 31 日到 9 月 29 日)的日志,按两家当前的 API 标价给每个 token 定价。
- Claude Code:约 9,400 美元的标价用量,26 个活跃天。大部分是 Opus 5 和 Opus 5.5,另有一些 Fable 5.1 和 Sonnet 5。
- **Codex,Pro 账号:约 3,600 美元。**其中 GPT-6 Astra 占 2,900 美元。
- **卡住我的是 Codex 的计量器。**9 月里有五个不同的周窗口,它的读数到了 99% 或 100%,我那点 Codex 额度也用完了。
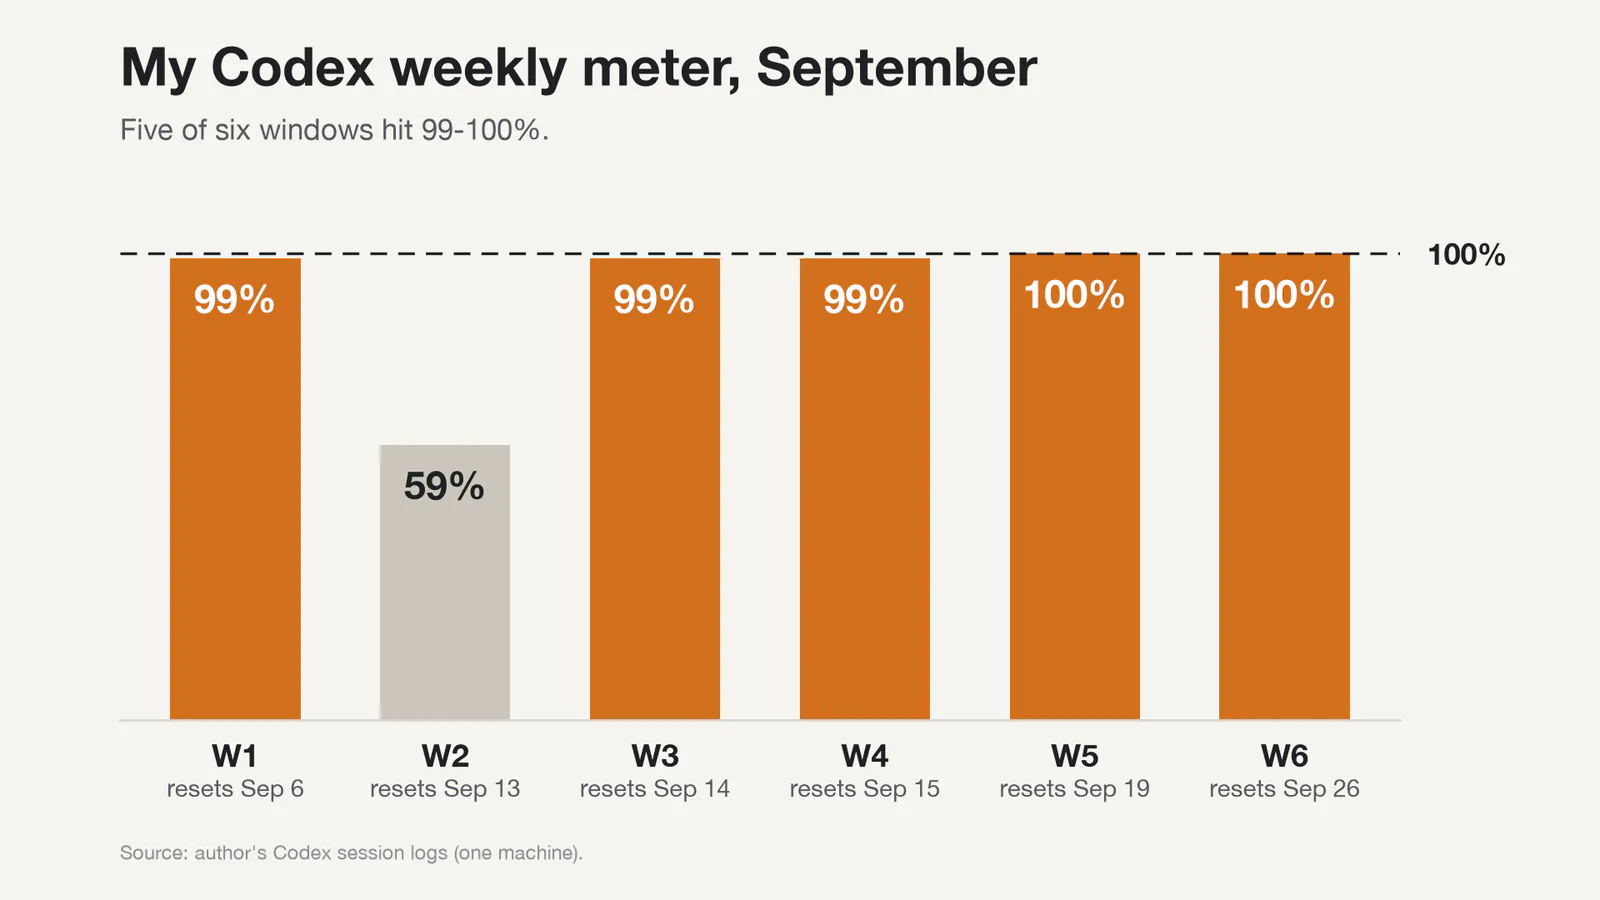
有两点必须说明。这些数字是“如果走 API 要花多少”,不是我实际付的钱。而且它们只来自一台电脑:Codex 的云端任务和 ChatGPT Work 不在这些日志里,所以 Codex 的数字是下限。这是一个重度用户的账单,不是基准测试。
即便如此,第一个结论很明确:对我这种用法,两个订阅都有大量补贴。抱怨 200 美元的 Pro“只”值几千美元的 API 用量,这个抱怨本身就有点奇怪。真正有用的问题是:每一份补贴能持续多久,哪个计量器先见底。9 月里先见底的是 Codex。10 月 30 日,它的预算还要减半。
真正的价格是“重读”
按账单项拆开以后,我原以为最重要的那一项并不重要。输出 token,也就是 Astra 上每百万 50 美元的那一行,只占一小块。大头是缓存读取:占我 Astra 成本的 78%、Opus 5 的 76%、Opus 5.5 的 58%。
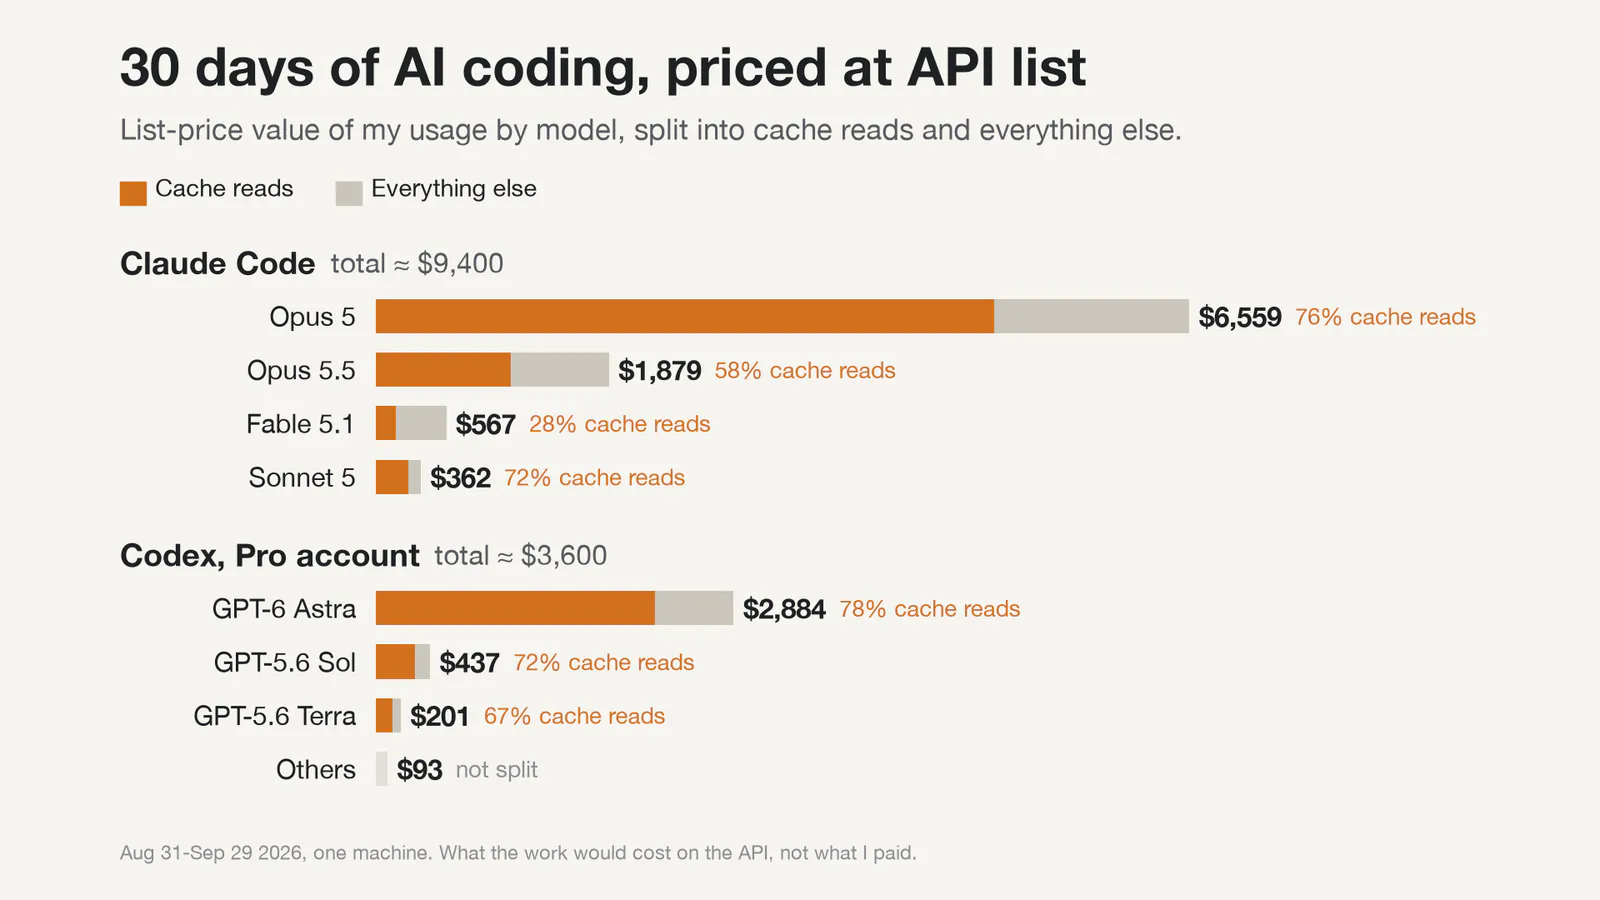
agentic coding 就是这样工作的。agent 不是回答一次就结束,而是在跑一个循环:加载仓库上下文、调用工具、读取结果、思考、再来一轮。每一轮都要把之前的对话重新读一遍。提示缓存让每次重读比全新输入便宜得多,但量非常大。30 天里,我的 Claude Code 会话从缓存里读了大约 170 亿个 token。
三周前,我写过把 Astra 用进真实工作:一个横跨 Azure、Linux 和 Windows 的部署任务。当时让我印象深刻的,是它能把整段工作接住,不用交回给我。可“接住整段工作”,就意味着把这段工作的上下文重读几百次。我当时称赞的能力,正是这张账单的主要来源。
所以对 agent 的工作来说,要紧的不是页面上醒目的输入和输出价格,而是缓存读取的价格:
| 模型 | 输入 | 缓存读取 | 输出 |
|---|---|---|---|
| GPT-6 Astra | $10 | $1.00 | $50 |
| Claude Opus 5 | $5 | $0.50 | $25 |
| Claude Fable 5.1 | $10 | $0.25 | $50 |
| Claude Opus 5.5 | $4 | $0.20 | $20 |
| GPT-6 Sol | $2 | $0.20 | $10 |
| GPT-6.1 Sol | $2 | $0.10 | $10 |
每百万 token,OpenAI 与 Anthropic 2026 年 9 月 30 日的官方标价。
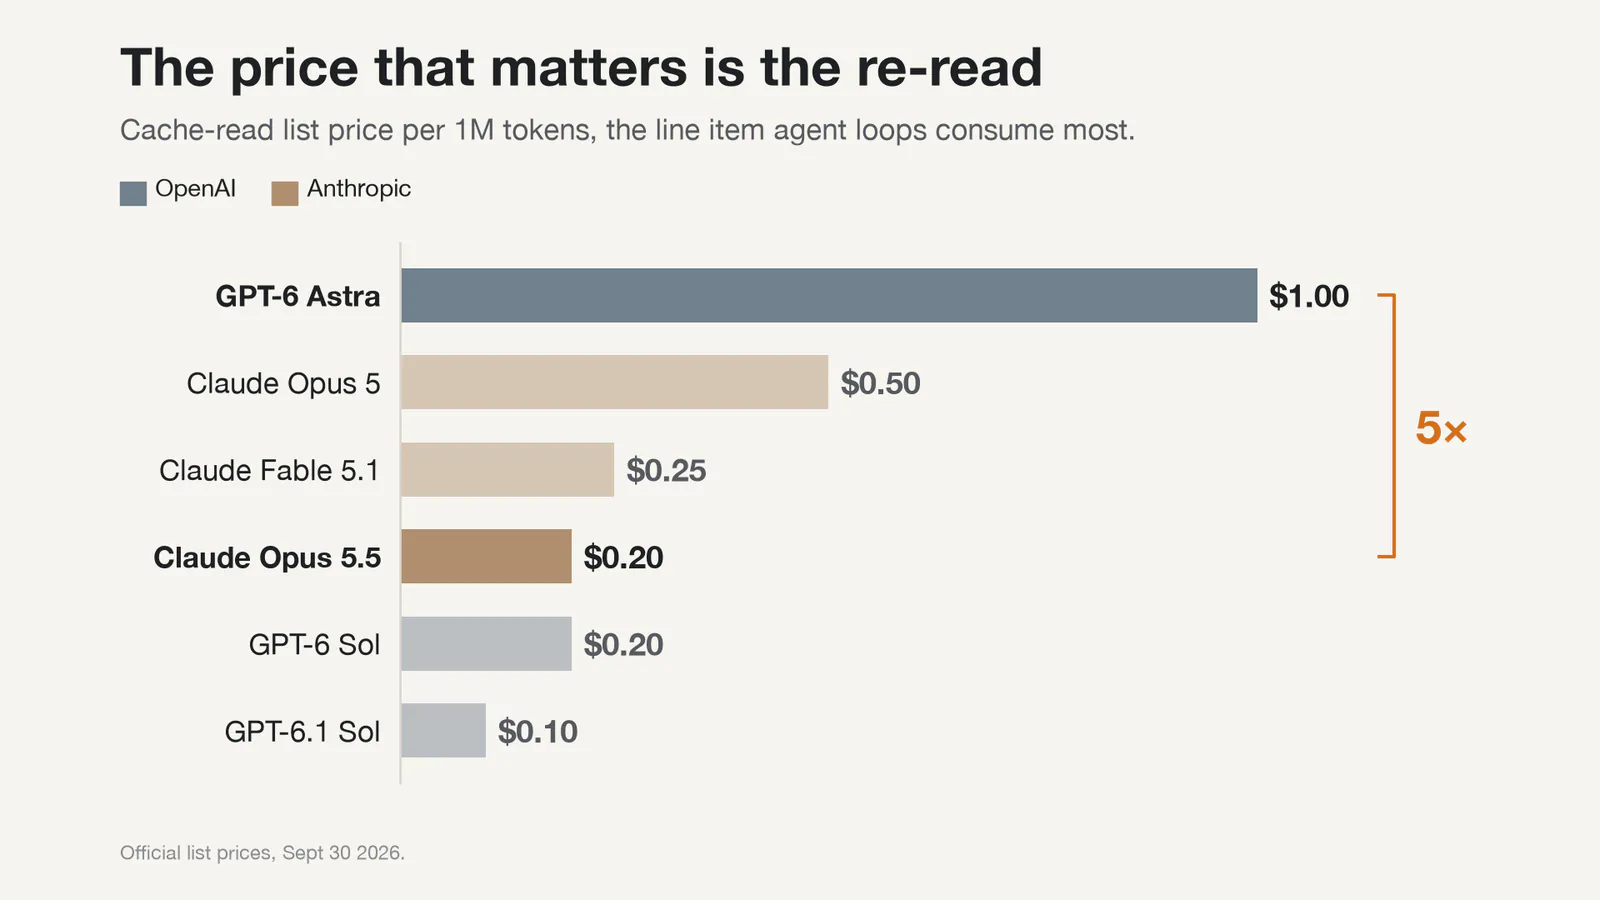
看中间那一列。Anthropic 现在对 Opus 5.5 的缓存命中只收输入价的 5%,Fable 5.1 只收 2.5%;OpenAI 的 GPT-6.1 Sol 缓存输入比输入价低 95%。Astra 仍然是 1 美元。在一个四分之三都是重读的工作负载上,Astra 的缓存价格是 Opus 5.5 的五倍。
所以哪个更划算?
就我 9 月的工作量而言,是 Claude Max,而且差距比我预想的大。同样 200 美元,Claude Code 承载了约 9,400 美元的标价用量;Codex 承载了约 3,600 美元就碰到了上限,而这个上限一个月后还要减半。
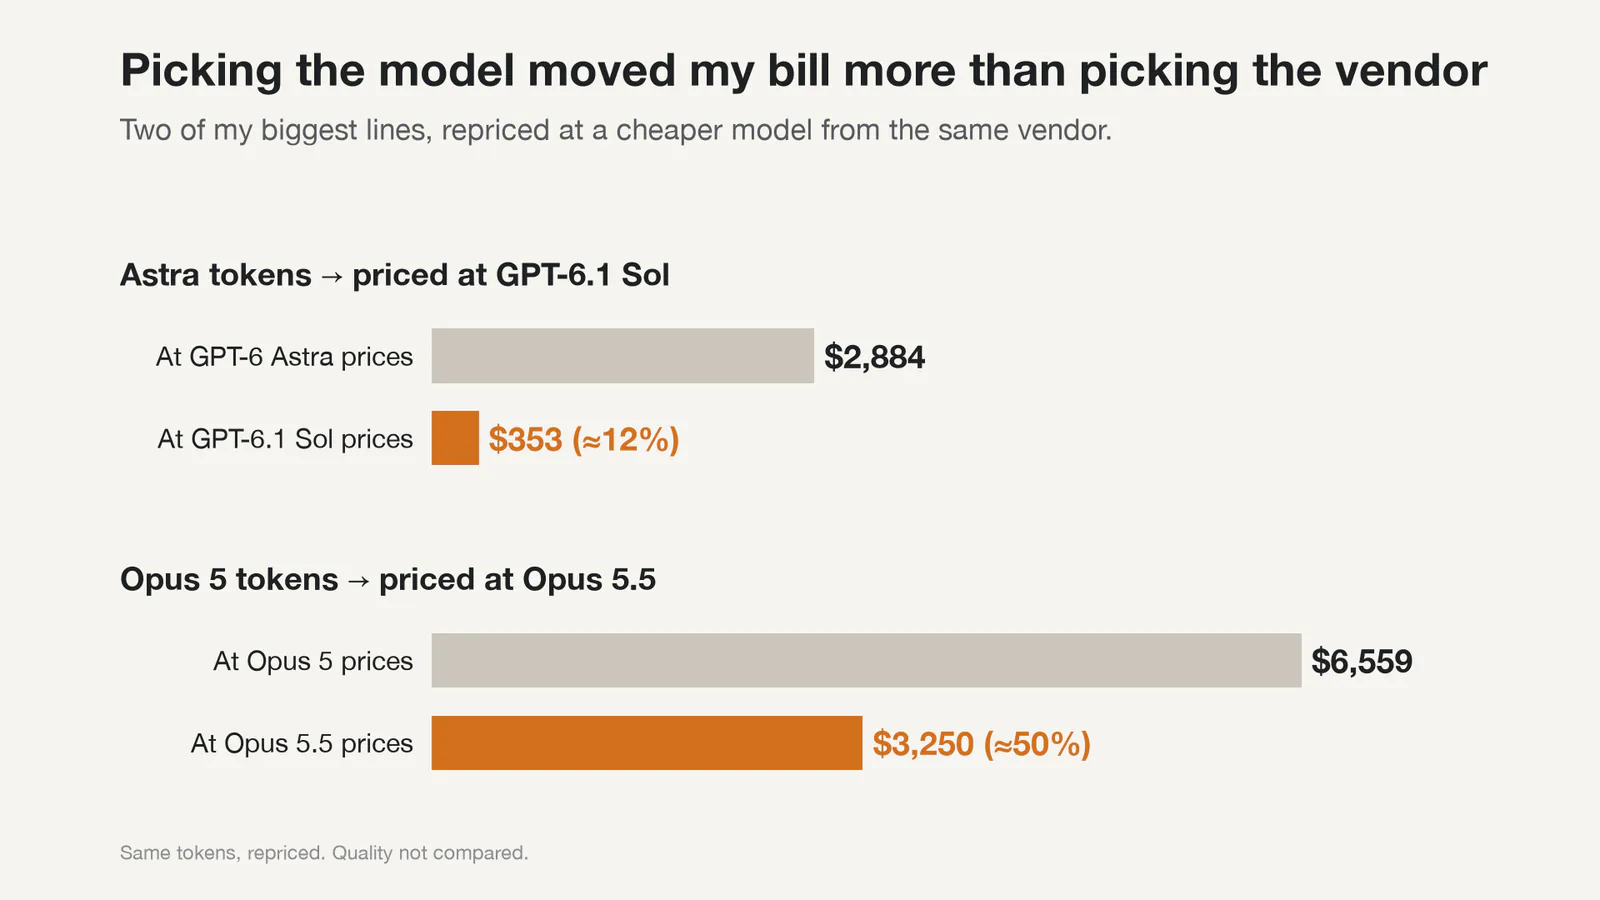
但我日志里最大的杠杆不是厂商,而是模型。把我在 Astra 上跑过的那些 token 按 GPT-6.1 Sol 的价格重算,约 2,900 美元会变成约 350 美元,大概 12%。Claude 内部也一样:Opus 5 的 token 按 Opus 5.5 重新定价,会从约 6,600 美元降到约 3,250 美元。选模型对账单的影响,比选公司还大。这也正是 OpenAI 这次押的注:大家把工作换到更便宜的模型上,减半后的额度照样能覆盖同样的工作。6.1 Sol 能不能做好我原来交给 Astra 的工作,我还没测过,所以现在这只是一个假设。
10 月 29 日之前,我会这样做:
- **Claude Max 继续当主力。**这边不用动。
- **Pro 200 至少保留到 12 月 31 日。**那 2,500 美元的额度能补上 10 倍和我实际用量之间的很大一部分缺口,而且年底就过期。我不买 Pro 500。更快的生成速度也许不错,但同样的单价多付 300 美元一个月,不值。
- 10 月找一周,让 Codex 默认跑 GPT-6.1 Sol,看周计量器怎么走。如果 Sol 能接住大部分工作,10 倍可能就够了,Astra 留给难的部分。
我对接下来的判断
下面是我的推断,不是任何一家公司宣布过的事。
**“20 倍”这种说法会慢慢淡出,美元预算会被直接显示出来。**OpenAI 已经在后台完成了换算,下一步顺理成章就是用美元显示计量器。Anthropic 也走了一部分:Max 套餐里能用于 Fable 的份额有上限,20 美元的 Pro 套餐用 Fable 则按 API 价格从按量付费的额度里扣。当套餐变成一笔预算,用户就会要求看到这笔预算。
**价格战会转向 agent 真正消耗的那几项。**9 月的降价落在了缓存读取和更便宜的“准前沿”模型上,而高端档位,比如 OpenAI 的 Ultrafast 和 Anthropic 的 fast mode,收的是速度的钱。我预计页面上的输入输出价格会越来越不重要,缓存定价和速度档会越来越重要。
**重度用户的补贴会继续缩小。**现在的套餐仍然很慷慨。但一家厂商公布了汇率,也就等于装好了一个旋钮,下次算力紧张时就会去拧。我会把订阅当成一笔带便利折扣的预付 API 预算来规划,而不是一张不限量通行证。
程序员现在该做什么
对管云基础设施的人来说,这些都不新鲜。新的是它现在也适用于我们写代码的工具了,因为订阅不再替你把计量器藏起来。
**知道自己的数字。**我的数字和网上流传的估算完全对不上。如果你用 Codex 或 Claude Code,你的 token 数已经在硬盘上了。给它们定价,我花了一个脚本和一个下午,结果改变了我的决定。
**按任务选模型,而不是按忠诚度。**默认用能过线的便宜模型,难的部分再交给前沿模型。在我的日志里,这个选择在单个账单项上相差最多 8 倍。
**把上下文当成一个成本中心。**每一轮都会重读上下文。拖着过期文件和巨大的工具输出跑几百轮的长会话,账单就是这么堆起来的。压缩上下文、一个会话只做一件事、把仓库说明写短,现在省的是钱,不只是 token。
**保持可迁移。**我的工作流放在 skills、AGENTS.md 文件和脚本里,在 Codex 和 Claude Code 里都能跑。所以换主力工具对我来说是一个价格决策,而不是一次迁移工程。汇率可能一夜之间改变的时候,能随时搬走的能力,比任何一个套餐都值钱。
一张终于能读懂的账单
过去几个月,订阅一直在替我付计量器的钱,我从没问过 Codex 计量器上的 100% 到底值多少。这周,OpenAI 告诉了我汇率,而且从现在起,它只付一半。
我并不生气。时机确实笨拙,“我们在调整用量的计算方式”也远不如“我们把额度砍半”来得诚实。但一个公布了汇率的订阅,比一个神秘的倍数更坦白,它也逼我做了早该做的事:读自己的账单。30 天的日志告诉我:我的 agent 大部分钱花在重读上;选模型比选厂商更影响账单;而我用得最重的那个工具,计量器正要缩水。
工程师学会读云账单,是因为账单决定了他们能造什么。AI 编程的账单正在变成同一种文件。读懂自己的那一张,现在是这份工作的一部分。